为软件工厂设计软件
关于将软件工程转化为智能体循环的思考。
自从我发表 AI-powered Software Engineering(2024)一文以来,奥弗顿窗口已经从“AI 能否以任何方式辅助软件开发”转变为“软件开发中还有哪些部分是人类完成的”。在工作中,我们一直在构建我所谓的“软件工厂”,这篇文章我想聊聊它是如何成型的、我们遇到的最难的部分,以及什么才是真正有效的。
什么是软件工厂?
虽然它正逐渐成为一个流行词,不同的人有不同的定义——我将其定义为一个 AI 驱动的系统及其周边组织,用于解决、设计、构建、测试和部署软件产品。如果你读过 The Transposed Organization,那么“软件工厂”只是现代 AI 原生公司必须作为 EPD(工程、产品、设计)运营核心部分开发的众多“循环”之一。
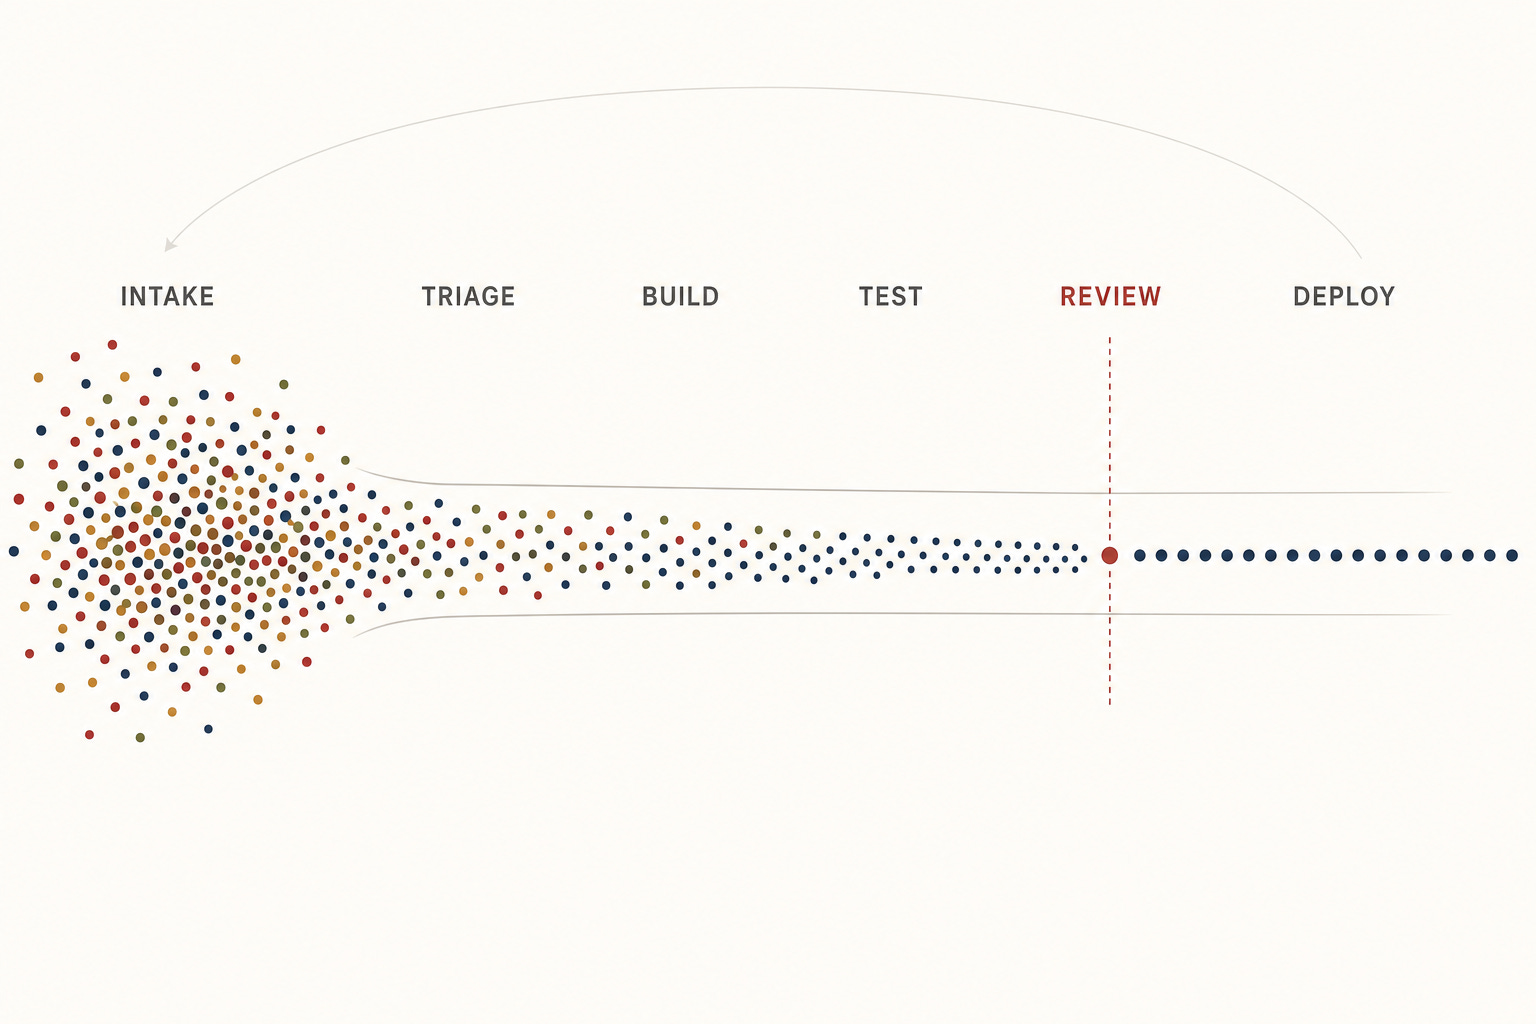
在我看来,一个完整的软件工厂必须:
能够以原始分布的客户生成的 RFE 和错误报告作为输入进行操作。如果产品经理需要为每个工单划定范围,或者工程师需要将解决方案拆分成更小的部分,那就不算数。
仅在需要人工退出(按下那个大红停止按钮)和在特定阶段进行审查时才需要人类。如果循环中任何地方有明确的“结对”步骤,或者 系统运行在个人的笔记本电脑上,那就不算数。
将每一条审查反馈都回流到系统中,使审查关卡随着时间的推移自我淘汰。如果审查只适用于单次软件生成,那就不算数(或者效果不好)。
能够并发地将许多请求通过循环处理,而不是一次处理一个工单。如果请求必须被串行化,因为各个阶段共享可变状态(一个测试/预发布环境、一个分支、一个部署槽位),或者吞吐量受限于人类拥有的资源而非支出,那就不算数。
你通常通过以下指标衡量软件工厂的一阶1效能:
周期时间——从客户请求到部署的墙钟时间(或每个阶段的时间)。
审查量——在各个阶段对 AI 起草的输出给出的反馈量(每个阶段)。
退出率——请求放弃并回退到人工参与的开发流程的频率(每个阶段)。这也可以重新表述为“工厂适用百分比”。
感谢阅读 Shrivu 的 Substack!免费订阅以接收新文章并支持我的工作。
播种一个软件工厂
为了不显得不够实用,我打算在这篇文章中专注于高层次的技巧,假设你已经初步搭建了某种软件工厂。它具体如何运作、端到端覆盖多广、是自建还是采购,确实会因公司而异。我主要见过两类:
AI 原生初创公司
通常有更大的空间来构建对 AI 友好的技术栈,合同和合规风险通常也较低。缺点是他们负担不起专门的 AI 开发运维团队来构建某种“软件工厂平台”。
建议:如果 Claude 为你选定了技术栈,那么你很可能可以直接找到某种“工厂即服务”的产品来购买。同样关键的是要提前设定预期:在没有中央平台团队的情况下,每位工程师都是其所负责系统的软件工厂架构师。
企业软件公司(我本人的真实写照)
迁移到对 AI 更友好的技术栈会成为一次相当大的迁移,而对风险(通常围绕服务稳定性)的容忍度低到几乎没有。他们确实也已经开始组建类似软件工厂的平台团队。
建议:至少在当下,自建可能比购买更容易,可以通过再组建一个专门的 AI 就绪平台团队来实现。一种常见的失败模式是购买了上限很低的产品,实际上无法让你达到发布一个"真正"功能所需的合规性和测试水平。另一个选择,适合那些足够大胆的人,是将所有新产品分叉到一个 AI 原生技术栈上,但这只有在隔离性足够好、不共享相同的合规性和稳定性风险时才真正划算。
不要把产品或平台当作软件工厂来启动
另一个或许有违直觉的观察是,软件工厂在有模式、契约和脚手架可供匹配时效果最好。纯绿地项目没有这些,过早地工厂化会导致代码膨胀,并降低随着项目演进理解项目的能力。另一个风险是缺乏关于项目如何演进以及将如何演进的数据——当系统本身"路线图感知"时,工厂效果最好。反过来说,棕地项目通常复杂、不直观,有大量未记录的行为(至少从编码代理的角度来看)。无论有没有 AI,设计良好的棕地项目实际上是应用工厂的理想场所。
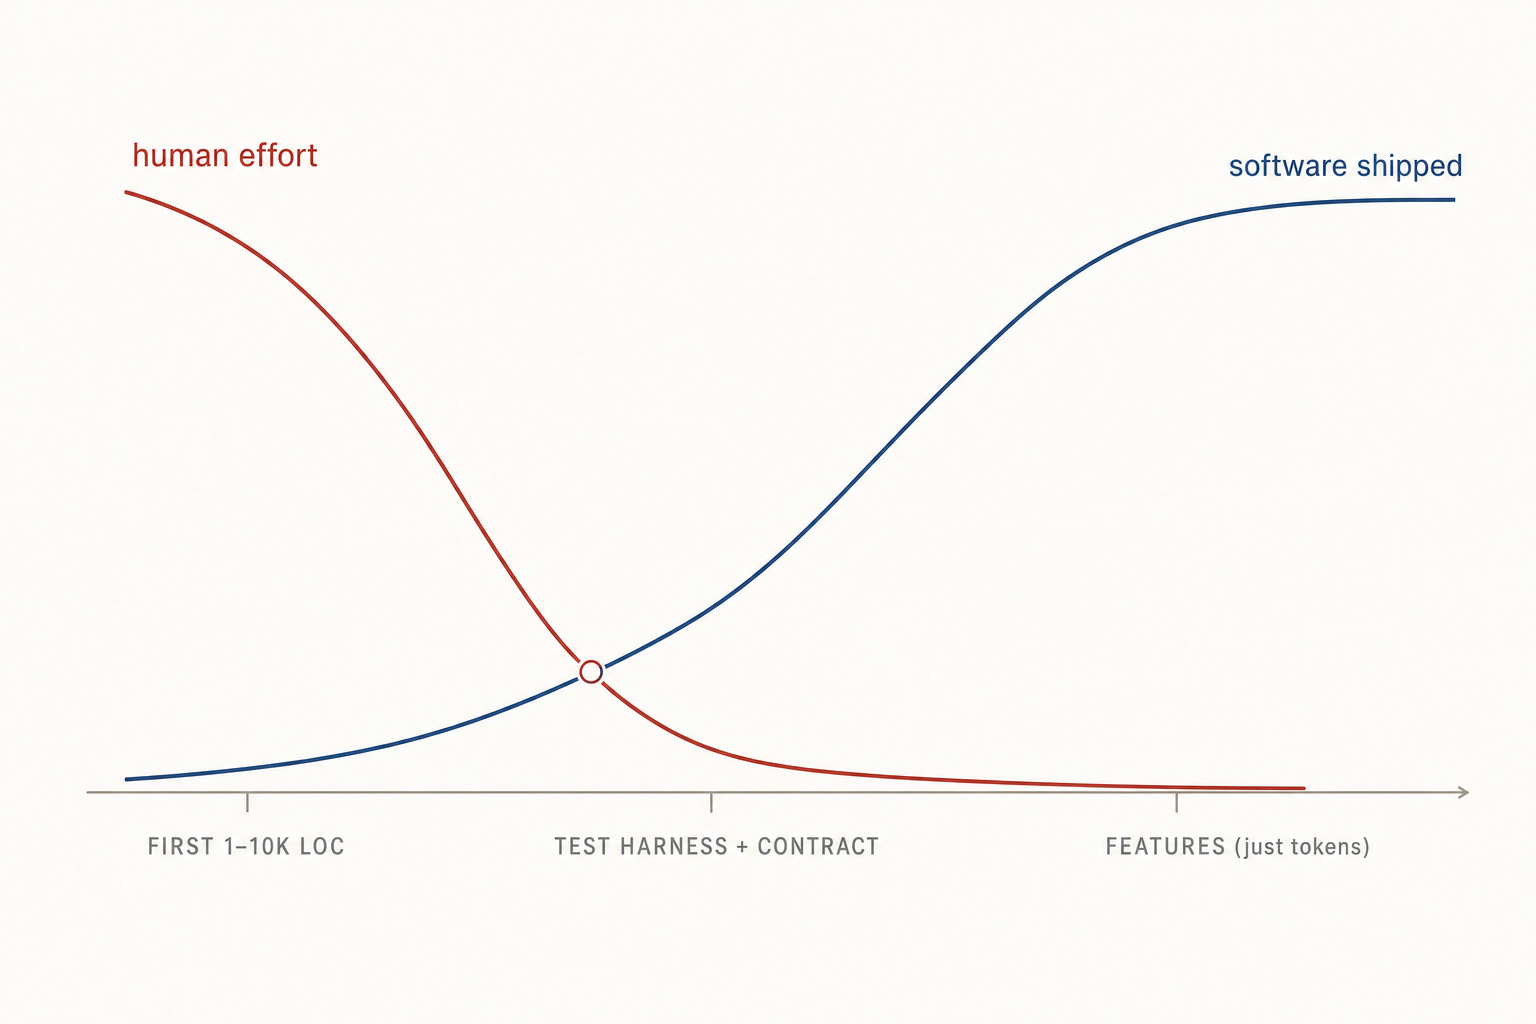
如果你刚刚开始一个项目(绿地),我会用编码代理结对编写前 3-10k 行代码,前几个端到端功能也是如此。按现代开发时间尺度,这个阶段大约需要 1-3 周。产品原型循环可能需要更长时间,我认为这超出了范围——在很大程度上,那些只是凭感觉编码的演示,成为实际生产项目的输入。
如果你正在处理一个超级复杂的企业服务(非常棕地),我会应用以下策略:
(1)让所有更改都可由代理测试。在物理上可能的最深层次上,AI 应该能够在没有人类参与的情况下,告诉你某个 PR 是否破坏了服务功能。
(2)在手动循环中,提示编码代理构建一个即将到来的功能(不要引导,让它自己设计、实现并进行端到端测试)。调整代码组织和/或添加 markdown 文件,直到这行得通。
如果(1)或(2)在规模上不可行,你应该重建或分解并重建服务的一个子组件,使这两者都成立。我知道这并非易事,但我要提出这样的主张:通常 [# 完成此事的工程小时数 - 因拥有工厂而减少的工程小时数] « [# 在有人类参与的情况下继续构建功能所需的工程小时数]
用契约来理解和维护工厂
只要你有正确的"契约"来规定这些项目应如何开发,你绝对可以构建和理解每天发布的数万行代码。契约可以有多种形式(模式、类型等),但通常我关注的是 markdown 契约(通常是 AGENTS.md 或与代码同置并被引用的 .md 文件)。
一个好的 markdown 契约:
对项目未来如何演进做出预测(我所说的"路线图"感知)
明确说明如何验证更改以及什么无法验证
在 90% 的情况下不会随功能变化而改变(例如,未来修改此文件的 PR 百分比非常低)
建立清晰的复杂度和风险边界(例如,x 是容易的事情的例子,y 是困难或有风险的事情的例子)
在路线图任务上进行前向测试(例如,一次性 vibe code,不做任何引导,路线图上的下 3 个项目,如果它们偏离太远,那么这个契约就是坏的)
定义智能体不会看到的关键上下文(例如,通常是产品和受众上下文,约等于一个“智能体应该知道但代码库中没有的内容”的缓存)
我写了一个 markdown 文件,但我的智能体还是很烂”这类人群通常 6 项中一项都没有,因为通常最容易(但错误)的做法是仅仅把 markdown 当作项目的摘要或一次性技术规格的存储。
以下是我用来编写这些内容的实用技能的一些片段2:
- Principles are the choices about what this service is and isn't, what it optimizes for, and what trade-offs it accepts. They are the decisions that *produced* the current code shape, not summaries of that shape. A good test: if you replaced every file in the directory with a different implementation that respected the principle, would the principle still read true?
- Where does stuff live? The high-level layout a reader needs to know to *find* things — what kinds of files exist, what naming conventions disambiguate them, where shared helpers live, what subfolders mean. This should stay true across normal feature work; you should NOT have to edit it on every code change. Do not enumerate files — for the live file list, point the reader at a command (e.g., `ls <dir>`, `tree <dir>`, `find <dir> -name '*.py'`) that returns the current state.
- What's the architectural contract? Which invariants must a change respect, and which boundaries — when crossed — mean this isn't a routine change but an architectural decision. These are the joints a reviewer looks for; name them by the symbols, interfaces, or middleware that anchor them.
- Which categories of change can a single engineer ship after a normal PR review, vs which categories likely require a design conversation before they're written.
一个值得思考的有趣问题——我认为通常 SWE1-2 甚至 SWE3 实际上并没有完整的上下文来真正回答并验证这 6 个要点的正确性(其中部分是经验相关的,但更多是作为组织产物)。在这种情况下,谁来编写契约?它必须以两种方式之一被拥有:由一个团队(一个契约设计评审会议?),或者由一个“转置”的产品工程师端到端地拥有该契约。
测试,测试,测试
智能体能够运行端到端测试在工程师中仍然被严重低估。我认为很多人仍然认为智能体能够运行测试的 ROI 来自于它替人类省去了运行测试命令的麻烦,因此在“让智能体运行我的测试”与“构建新功能而我自己运行测试命令”的优先级之间,感觉它不必在这个冲刺中完成。
现实是,今天的模型在设计良好的测试测试框架下能够编写出令人惊讶地正确且复杂的软件。我喜欢认为这有点类似于强化学习中的“奖励”函数——定义一个将解决方案映射到分数的函数,让智能体通过爬山法不断优化直到最大化它。那么关键就变成了你如何实际定义两者:
从整体上看,正确意味着什么?从单元测试,到集成测试,到游戏测试,再到与项目“契约”的一致性。
当不正确时,我们如何向智能体提供足够的信号,使其能够高效地朝着更高分数努力?从堆栈跟踪,到精心设计的子智能体评审,到浏览器使用截图验证。
换句话说,在这个 AI 原生工厂开发的新世界中,构建任何给定功能的人工工程工作实际上应该来自于搭建测试框架和契约的工作,而不是构建功能本身。如果你做得对,你的路线图应该看起来像:
分层测试
我的思维模型通常是:
代码检查、类型检查
单元测试
安全和合规扫描
单服务集成测试(其他一切使用 mock/shim)
多服务集成测试
从产品界面进行的多服务集成测试(在真实 UI 上点击按钮)
发布监控(如果是生产环境则在代码评审之后,根据预期集合验证日志和指标)
你可以将每个层级实现为一个 MCP 或 CLI,由智能体在完成该层级后运行3。关键在于智能体要掌控完整的测试循环——我常见的一个设计错误是把这些层级设为人工把关的阶段(例如测试部署需要人工介入),因为这会彻底拖垮工厂的自主循环周期。另一个常见错误是把测试做得过于僵化(例如硬编码的 playwright 测试),而不是给智能体足够的灵活性来动态确定测试计划,并在测试循环中真正修改测试计划。目标是定义一组测试层级,如果这些层级全部通过(再加上一些契约审查子智能体的签核),你就有很高的把握认为工厂产出的是高质量、合规的功能。
另外三条建议:
给你的智能体一个存放验证脚本的地方(例如每个项目都有一个 scripts/ 文件夹)。就让它把东西丢在那里,由它自己决定某个脚本何时失效、何时直接写个新的。
让你的测试智能体充当客户。测试不必纯粹是“x 功能是否正常工作”,也可以是“这对 x 受众来说会是愉快的体验吗”。随着模型能力提升,你通常可以采用更抽象、对最终用户更有意义的正确性定义。
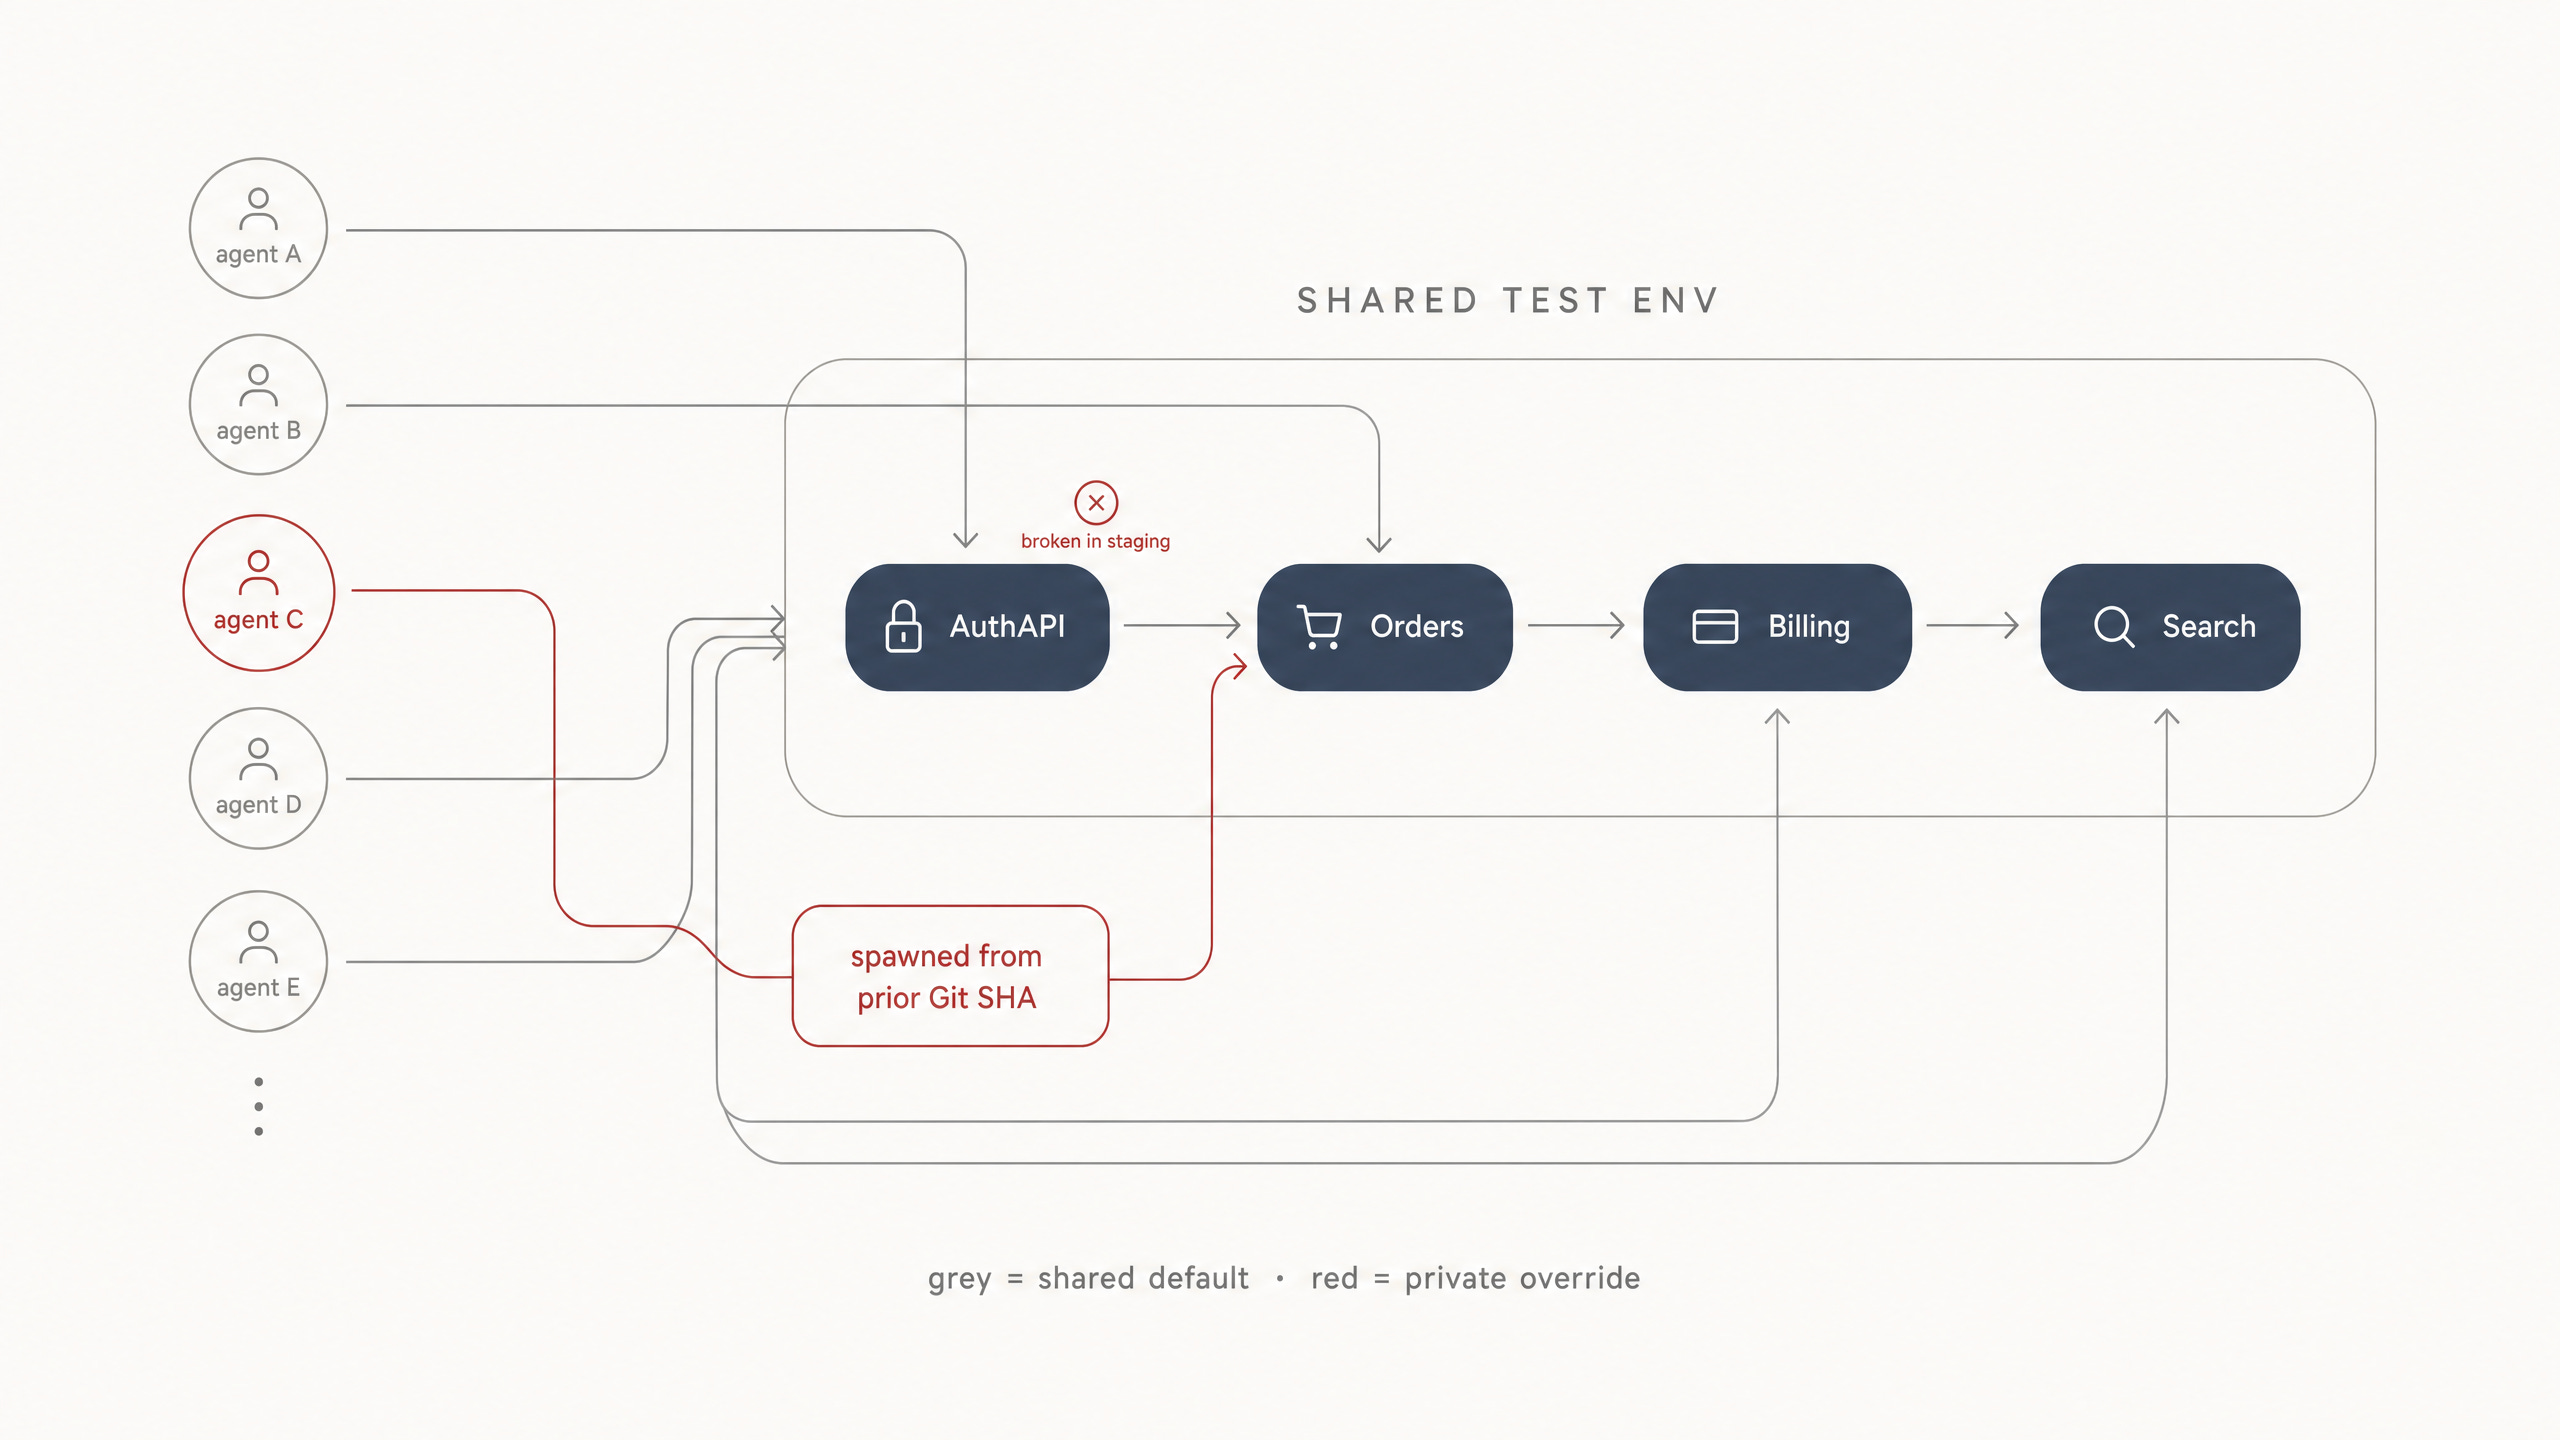
给你的智能体搭建测试环境的能力。我们开始采用一种有趣的策略(值得单独写一篇博客)来处理多服务集成测试。我们不再试图维护或引导整个平台的测试/预发布实例(这既困难又极其昂贵),而是让所有智能体访问一个共享测试环境,能够动态重启某些服务,并将自己测试的流量重新路由到这些服务上。如果 AuthAPI 因为另一个智能体而在预发布环境中损坏,我们的智能体会从之前的 Git SHA 启动一个新节点,并将测试别名指向它。
退出机制、可观测性与反馈循环
工厂无法覆盖 100% 的功能请求,也不会总是产出完美的代码,但当它们出错时,让这些失败反馈回系统是至关重要的。根据是否有人员把关某个阶段(出于 QA 和/或合规原因),我通常看到两种算法。
人工审查者(例如代码生成和测试之后、合并之前4)
如果实现完全跑偏,提供两个选项:要么完全切换到手动模式,要么带着一些额外说明重新运行上一阶段(“我们不要动 auth.py,用 xyz 框架来做这个”)。审查很少针对原始产物(完整的 diff)进行,而是针对从项目契约和测试循环产物中提炼出的、需要审查的重点内容。
将(智能体轨迹、反馈)存储在某处
以批量方式(大约一周的量级),智能体会推送对 markdown 契约和代码的更改,以防止该失败再次发生。这些通常也经过人工审查,并对所有反馈和失败模式进行汇总。
以批量方式(大约数周到数月的滚动周期),智能体会推送对 markdown 契约和代码的更改,并附带关于二阶效应的上下文:
工厂阶段的成本和延迟
事故、事后复盘、回滚
在线系统日志和指标
产品反馈和成果
无人工审查者(例如合并之后、发布验证)
将智能体轨迹存储在某处
在批量模式(时间跨度约为数周到数月)下,智能体会推送对 markdown 契约和代码的更改,并附带关于二阶效应的上下文:
工厂阶段的成本与延迟
事故、事后复盘、回滚
在线系统日志与指标
产品反馈与成果
两条路径都共享漫长的二阶循环;只有人工审查者路径会增加即时反馈编码。而且在实践中,无论走哪条路径,二阶反馈 PR 本身总是会由最初撰写它们的同一个人进行详细的人工审查。我尝试让自主二阶反馈工厂运转起来,到目前为止的结果是 正反馈垃圾循环。
这里最难的部分往往在于管理审查者的认知负荷,以及让反馈具有粘性(即将针对某个工厂实例给出的反馈转化为一种系统性的模式加以采用)。对此我并没有什么太好的答案,除了“擅长撰写那些在大多数情况下能让更改易于审查的契约”。
最后的一些看法
听到的(引述 + 我的看法):
“AI 还不够好,无法胜任 <插入非编写代码的工厂阶段:产品决策、根据这些决策设计技术规格、复杂且可信的测试>”
到了这个阶段,这主要是个技能、上下文或技术栈的问题——而这些都在你们团队的掌控之中。模型和运行框架对于端到端(E2E)SWE 工厂来说已经足够好了。
“即使在 QA 环节,软件工厂也不需要人工审查,因为我们可以投入更多智能体来快速修复它们发布的 bug”
我非常信奉“左移”(shift-left)理念,这意味着问题要在循环中尽可能早地得到解决和缓解,或者理想情况下尽可能在循环之外解决。发布有缺陷的更改(哪怕只是暂时的)会招致被另一家利用 AI 更快发布优质更改的公司“AI 工程化”超越,也会导致陷入无人在任何深度上理解系统、无法分辨更改好坏的境地。
感谢阅读 Shrivu 的 Substack!免费订阅即可接收新文章并支持我的工作。
一阶指标相当容易衡量,但它们并非全貌。事故、客户反馈、与工厂产出相关的代码回退等,都有助于将生产转化为业务成果。
你也可以直接把整篇博客文章丢给 Claude 来确定下一步。
测试 MCP 接口其实可以非常简单——exec_bash_in_environment()。复杂性在于要在正确的数据治理和安全保证下完成这项工作。
拉取请求(PR)的审查与合并通常是软件工厂中进行人工审查的一个非常自然的检查点。它既是把关正确性的环节(“代码一旦合并即被视为正确”),也被合规团队用作控制面(例如 SOC 合规)。由此产生的结果是,我认为随着 PR 成为工厂工作的基本单元而非其他,我们将不得不打破“更改应具有一定规模”这一契约。