构建多智能体系统(第 3 部分)
扩展基于脚本的智能体以可靠处理复杂问题的更新方法。
我认真研究智能体(agent)开发至今已超过两年,如果要找出一个不变的规律,那就是构建它们的“元方法”(meta)似乎每六个月就会经历一次彻底的重置。
在第一部分(早在2024年12月)中,我们构建的是高度领域特定的多智能体系统。当时,我们必须将多个脆弱的子智能体组件串联起来,以弥补模型能力的不足。在那时,人们还不清楚模型本身的原始改进会在多大程度上淘汰那些架构。
在第二部分(2025年7月)中,大语言模型(LLM)已经取得了显著进步。我们将架构简化为围绕“编排者”(Orchestrator)智能体和工作节点的模式,并且首次看到一丝曙光:脚本编写可能不仅仅用于数据分析。
现在,我们来到了第三部分(2026年1月),范式再次发生了转变。一个越来越明显的趋势是,最高效的智能体正在通过使用代码来解决非编码问题,并且它们使用的是一个一致的、与领域无关的框架(harness)。
在这篇文章中,我想更新一下我所见过的智能体设计(基于构建智能体、使用最新的AI产品以及与智能体领域的其他同行交流1),并剖析过去几个月里架构又是如何演变的。
感谢阅读 Shrivu 的 Substack!免费订阅即可接收新文章并支持我的工作。
哪些没变,哪些变了?
自上次更新以来,我们看到了工具和模式的整合。虽然核心原语保持不变,但我们将它们粘合在一起的方式已经从僵化的架构转变为流动的、代码优先的环境。
保持不变的方面:
基于工具使用的LLM智能体: 我们从根本上仍然依赖通过“工具”与世界交互的大语言模型。
用于驯服复杂性的多智能体系统: 随着系统规模的增长,我们仍然需要分解问题。然而,我在第二部分中提到的趋势(智能越多,架构越少)已经加速。我们越来越少地依赖僵化的“流水线”,而是更多地依赖模型固有的推理能力来导航问题空间。
长周期任务: 我们正在越来越多地解决需要相当于人类数小时时间的任务。即使上下文窗口被数千次工具调用填满,智能体现在也能保持能力。相当于人类的时间跨度还在持续增长2。
发生变化的方面:
上下文工程是新的导向方式: 越来越少地涉及提示词(prompt)、工具或框架的“工程”,而更多地涉及“上下文工程”(组织环境)。我们通过管理智能体的文件系统、创建 markdown 指南文件以及渐进式注入上下文来引导它们。
沙箱成为默认配置: 由于智能体越来越多地通过编写代码来解决非编码问题(例如,“通过编写 Python 脚本来分析这个电子表格”而不是“逐行读取这个电子表格”),它们需要一个安全的地方来执行这些代码。这意味着现在几乎每个严肃的智能体都会获得一台个人的临时计算机(虚拟机)来运行。3
务实的工具调用:我们正在转向程序化的工具调用方式,智能体编写脚本以循环、批量或复杂序列的方式调用工具。这极大地提高了 token 效率(智能体读取的是脚本的输出,而不是 50 次中间 API 调用),并降低了延迟。
领域无关的框架:随着模型的改进,为特定产品定制智能体框架的需求正在消失。在我最近构建的几个智能体中,当我可以直接封装一个通用实现(如 Claude Code,即 Agents SDK)时,很难证明维护自定义循环是合理的。通用框架通常对 90% 的用例来说都“足够好”。
更新后的多智能体架构
作为这些变化的副产品,我们在 2024/2025 年看到的多样化的智能体架构“动物园”正在收敛为单一的主导模式。我将把它分解为核心组件。
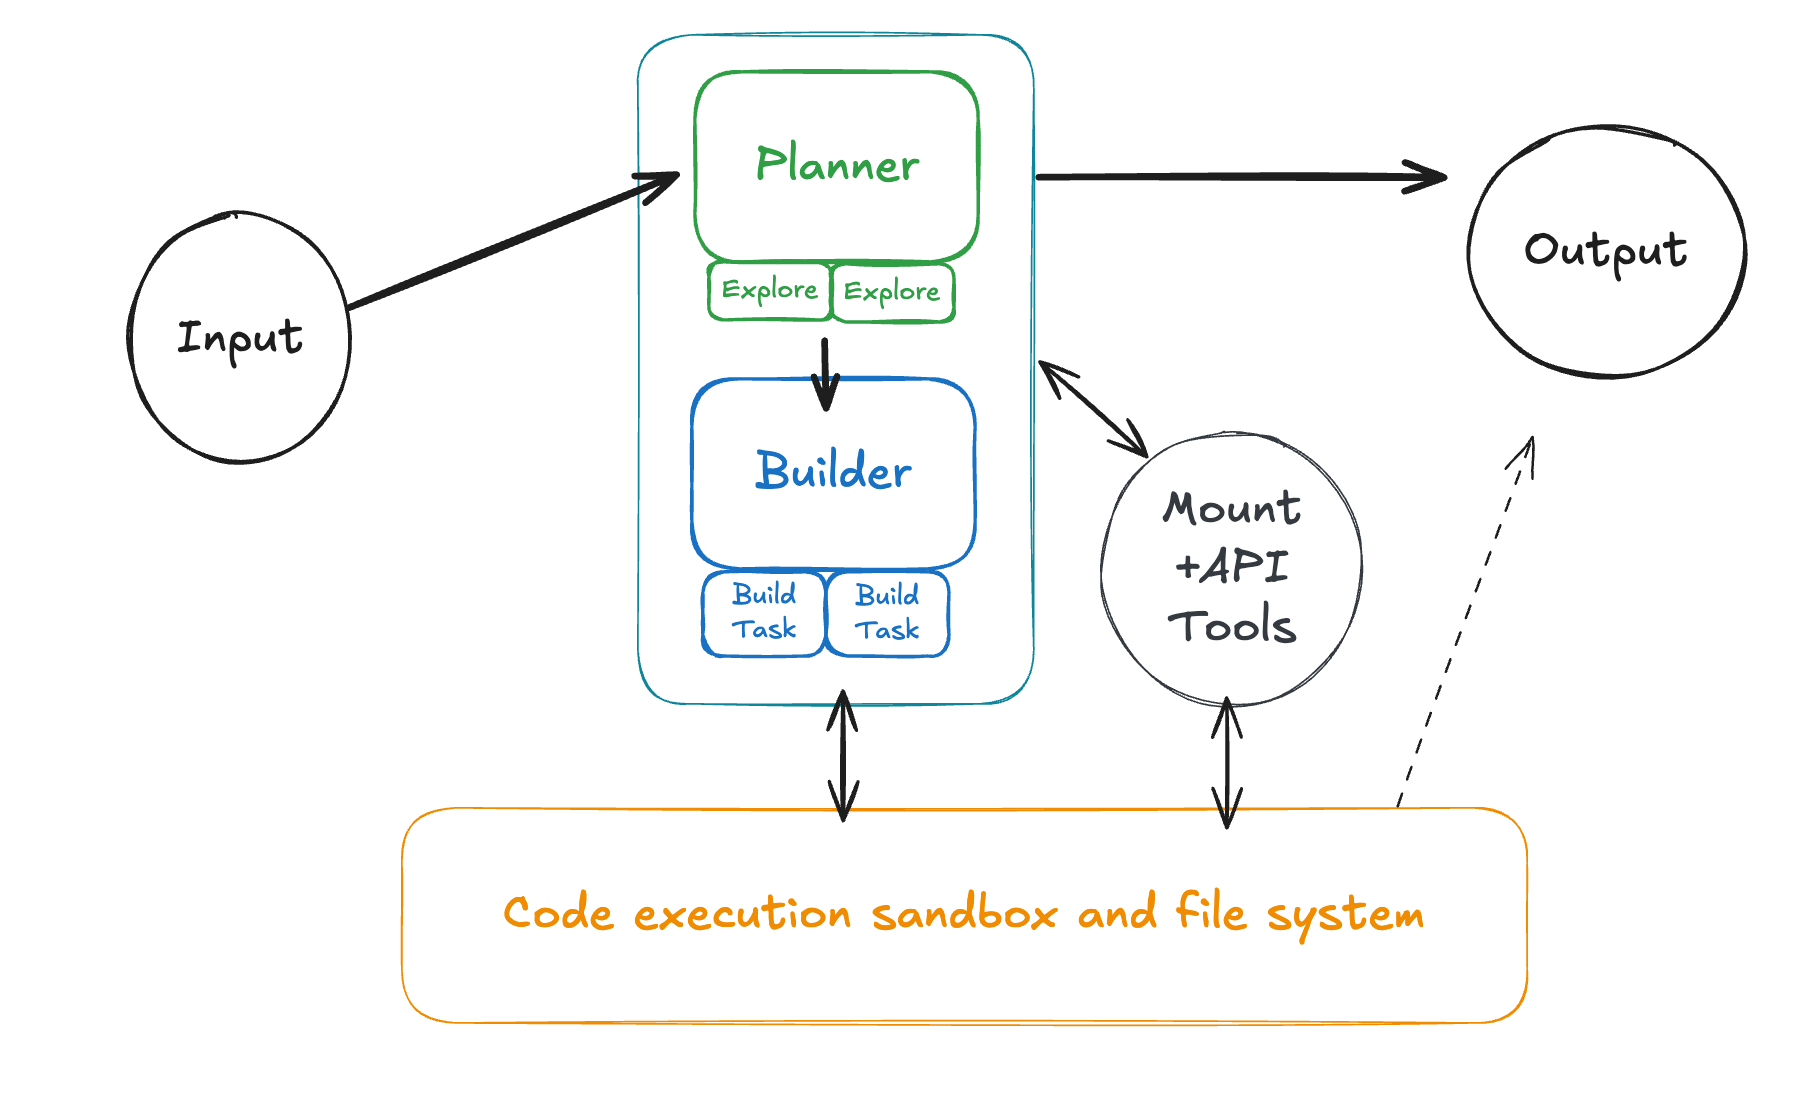
规划、执行与任务
过去 18 个月中最大的转变之一是子智能体的简化和泛化能力的提升。过去,我们会手工设计特定的角色,如“SQL 专家”或“研究员”。如今,我们开始看到只有三种形式的智能体在循环中协作以完成任务:
Plan Agents —— 一个专门负责发现、规划和流程优化的智能体4。它进行恰到好处的研究,以生成问题地图,为执行智能体提供具体的指引和定义,以便其接手。
Execution Agents —— 拿到计划后去执行任务的构建者。它从规划者提供的指引中加载上下文,编写脚本来操作该上下文,并验证自己的工作。
Task Agents — 由规划或执行智能体调用的临时子智能体,用于并行或隔离的子操作。这可能看起来像是给规划者的“探索者”智能体,或是给执行智能体的“对第 X/10 个分块执行操作”。这些通常作为工具调用动态启动,子任务提示由调用智能体即时生成。
这与旧架构(如我在第 2 部分中写到的“主管-专家”模式)形成鲜明对比,在旧架构中,人类工程师必须手动定义每个子智能体的领域边界和职责。
智能体虚拟机
这些新的智能体需要一个环境来管理文件系统上下文并执行动态生成的代码,因此我们为它们提供了一个 VM 沙盒。这极大地改变了你对工具和能力的思考方式。
核心 VM 工具设计
为了与 VM 交互,有一组通用的基础工具,它们已成为大多数智能体实现中的标准5:
Bash — 运行任意 bash 命令。像 Claude 这样的模型常常会假设环境中已经存在某些工具,因此在虚拟机上预先安装一套标准的 unix 工具(python3、find 等)至关重要。
Read/Write/Edit — 基本的文件系统操作。在 Claude Code 这类系统中,编辑通常通过
replace(in_file, old, new)格式进行,这往往是更可靠的执行编辑的方式。Glob/Grep/LS — 专用的文件系统探索工具。虽然它们与
Bash可能显得冗余,但通常仍会被包含进来,以实现跨平台兼容性,并作为针对常见操作的更精炼、更节省 token 的别名。
这些工具的定义看似简单,但要稳健实现需要大量防护措施。你需要处理 bash 超时、在巨大的读取结果进入上下文窗口之前将其截断,并添加检查以防止对文件的意外编辑。
自定义工具设计
随着智能体现在能够操纵数据而不直接触碰其上下文窗口,也不必为每一步都进行显式工具调用,你可以简化自定义工具。我看到主要有两种类型的工具出现:
"API" 工具 — 这些是为 程序化工具调用 设计的。它们看起来像是对数据源执行 CRUD 操作的标准 REST 封装(例如
read_item(id)而非复杂的search_and_do_thing_with_ids(...))。由于智能体可以在脚本中组合这些工具,你可以暴露大量细粒度的工具接口,而无需浪费“始终附加”的上下文 token。这也解决了 许多类 API 的 MCP 服务器设计中的一个核心问题。"Mount" 工具 — 这些是为向智能体的虚拟机文件系统批量注入上下文而设计的。它们将外部数据源复制并转换为一组智能体可以轻松操纵的文件。例如,
mount_salesforce_accounts(...)可能会将 JSON 或 Markdown 文件直接写入像./salesforce/accounts/6 这样的虚拟机目录。
脚本友好的能力
脚本驱动的智能体还让你在如何使用代码解决非编码任务方面更具创造性。你不必为每个操作构建专用工具,而是提供原语,让智能体自行构建解决方案:
你可能更倾向于让智能体通过 Python 脚本间接构建产物(通过 python-pptx 制作 PowerPoint),然后运行单独的 linting 脚本以编程方式验证输出,而不是依赖黑盒或手工编写的
build_pptx(...)工具。你可以让智能体访问原始二进制文件(PDF、图像)以及预装的库,如
pdf-decode或OCR工具,让它编写脚本精确提取所需内容,而不是依赖预先文本编码的表示。你可以将复杂的数据对象表示为可搜索文本文件的集合——例如,将 GitHub PR 挂载为
./pr/<id>/change.patch和./pr/<id>/metadata.json,以便智能体可以使用标准的grep工具在其中进行搜索。你可以在虚拟机中使用一个“假”的 git 仓库来模拟草稿和发布流程,允许智能体提交、分支和合并更改,这些更改随后被转换为产品概念。
你可以向虚拟机中预置一批示例 Bash 或 Python 脚本库,供智能体在运行时调整或重用,从而有效地构建一个动态的“技能”库。
上下文工程
上下文工程(相对于工具设计和提示工程而言)在这种范式中变得越来越重要,它用于将一个领域无关的智能体框架适配为在特定产品领域中可靠运行。
网上现在有几篇优秀的指南,所以我不会在这里展开太多细节,但核心概念是相当通用的。我的TLDR是,它通常可以分解为三种核心策略:
渐进式披露——你从一个初始的系统提示开始,并设计上下文,使智能体仅在调用工具时才高效地积累它所需的信息。
你可以在工具或预构建脚本的输出中包含即时使用说明。如果智能体尝试
api_call(x)并失败,工具输出可以返回错误以及文档中关于如何正确使用它的片段。你可以使用放置在文件系统中的markdown文件作为任务的可选指南。VM根目录中的
README.md列出了可用的功能,但智能体只有在决定需要运行查询时才会读取特定文件,如docs/database_guide.md。
上下文间接——你利用脚本能力,让智能体在不实际看到上下文窗口内内容的情况下对上下文进行操作。
智能体不是将一个500MB的日志文件读入上下文来查找错误,而是编写一个
grep或awk脚本来查找匹配“ERROR”的行,并且只读取该脚本的特定输出。你可以拦截文件操作以执行“盲读”。当智能体尝试读取像
./articles/<topic>.txt这样的占位符路径时,框架会拦截此写入,执行搜索,并即时将相关片段填充到文件中。
简化——你利用预训练模型的先验知识来减少对上下文的需求,并更多地依赖智能体的直觉。
如果你有一个复杂的内部图数据库,你可以给智能体一个
networkx兼容的包装器。模型已经完美地知道如何使用networkx,因此零样本性能显著高于教它一种自定义查询语言。如果你的系统使用遗留或晦涩的配置格式(如带有自定义schema的XML),你可以在智能体读取时自动将其转换为YAML或JSON,并在智能体保存时将其转换回来。
待办事项、提醒和压缩
对于需要执行越来越长时间运行任务的智能体,我们仍然不能完全信任模型在数千个token上保持专注。上下文衰减是真实存在的,对话早期的状态指示器通常会变得过时。为了应对这一点,像Claude Code这样的智能体通常使用三种技术来维护状态:
待办事项——这是一个元工具,智能体用它来有效地维护一个持久的TODO列表(通常由规划智能体初始化)。虽然这对面向用户的UX很棒,但它的主要功能是将剩余的计划和目标重新注入到上下文窗口的末尾,即模型注意力最集中的地方。7
提醒——这涉及框架在工具调用结果或用户消息末尾动态注入上下文。框架使用启发式方法(例如,“自上次关于X的提醒以来已进行了10次工具调用”或“用户提示包含关键词Y”)来为智能体附加提示。例如:
if user_focus.contains("checkout-button"); tool_result += "<hint>The user’s focus is currently on the checkout button component.</hint>"自动压缩 —— 在某个时刻,几乎整个可用上下文窗口都被过去的工具调用和结果占满。通过启发式方法,将上下文窗口交给另一个智能体(或仅一次 LLM 调用)来总结历史,并从该总结中“重启”智能体。虽然从总结中恢复的效果仍有争议,但这总比撞上上下文限制要好,而且当与输入计划中的显式检查点结合时,效果会显著提升。
智能体体检
如果你在六个月前构建过一个智能体,我有个坏消息:它很可能已经是遗留代码了。向脚本化和沙箱的转变非常显著,重写往往比改造更好。
以下是评估你当前架构是否需要重构的快速评分标准:
框架(Harness):你是否在维护一个为你的产品硬编码的领域专用架构?考虑重构为一个通用的、与领域无关的框架,将领域逻辑委托给上下文和工具,或者包装像 Agents SDK 这样的标准实现。
能力(Capabilities):你的提示词是否充斥着冗长的工具定义和子智能体指令?考虑将这些逻辑移入“Skills”(markdown 指南)和文件系统结构中,让智能体可以逐步发现它们。
工具(Tools):你是否有一个庞杂的特定工具库(例如
resize_image、convert_csv、filter_logs)?考虑删除它们。如果智能体有沙箱,它很可能只需编写一个脚本就能更好地解决所有这些问题。
未解问题
我们仍处于这种新“配备计算机的智能体”范式的早期阶段,虽然它解决了 2025 年的许多可靠性问题,但也引入了新的未知数。
沙箱安全:多大的灵活性算过度?给智能体一个虚拟机和执行任意代码的能力,为安全漏洞开辟了一个全新的攻击面。我们现在将敏感数据混合在(可能)具有互联网访问权限和包管理器的容器中。防止复杂的数据渗出或意外破坏是一个尚未解决的问题。
自主性的成本:我们不再只是为推理 token 付费;我们还在为运行时计算(虚拟机)以及可能数千次的内部工具循环付费。如果一项任务能节省一个人一小时,我们是否在意它现在成本高得多?还是我们只是押注于“计算便宜到不值得计量”的未来会比我们的云账单来得更快?
“上下文工程”的寿命:今天,我们必须深思熟虑地组织文件系统并编写那些 markdown 指南,以便智能体能找到它们。但这是否只是暂时的优化?六个月后,模型是否足够聪明(且上下文窗口足够便宜),以至于我们可以直接把它们指向一个杂乱无章、没有文档的数据湖,然后说“自己搞定”?
感谢阅读 Shrivu 的 Substack!免费订阅以接收新文章并支持我的工作。
我给旧金山科技 AI 圈起的新梗名,看看能不能火。
我其实非常不喜欢 METR Time Horizons 经常以此作为证据——但同时我无法否认 Opus 4.5 在编码任务上相比以往模型能走多远。
另见 Davis 的精彩文章:
你可以在 Cursor 的 Scaling Agents(需要说明的是,这个浏览器相关的内容对我来说有点营销炒作的意味;不过仍是一个很酷的基准测试和技术)和 Anthropic 的 Effective harnesses for long-running agents 中看到更多关于规划与执行交接在实践中如何运作的细节。
我对 Claude Code 风格的工具有点过度拟合了(完整列表见这里),但我持续的理解是,它们在各个 SDK 之间相当相似(或者将会如此)。
我们在工作中经常这样做,我发现 Vercel GTM Engineering 做的事情看起来非常相似。