探索 Claude/GPT 知识截止日期与预训练时间线
一篇略有趣味的分析,探讨模型知道什么,以及这揭示了它们是如何被训练的。
我们可以通过用精心设计的请求对模型进行“探测”,来了解前沿模型训练方式的隐藏事实。
通过在小众事实上对它们进行评分,我们可以估算出 GPT-5 和 Opus 等模型拥有多少参数,使用的是“不可压缩知识探针”
通过测量模型如何拆分词元,我们可以揭示用于训练模型的数据集混合(或至少是分词器)的相关事实,使用的是“数据混合推断”
通过在日期或自我识别相关问题上对它们进行评分,你还可以估算训练时间线(本文)
这里的一切都是估算。鉴于没有太多可公开验证的基准真相,本文中的某些推测可能完全错误。
前沿模型的训练方式
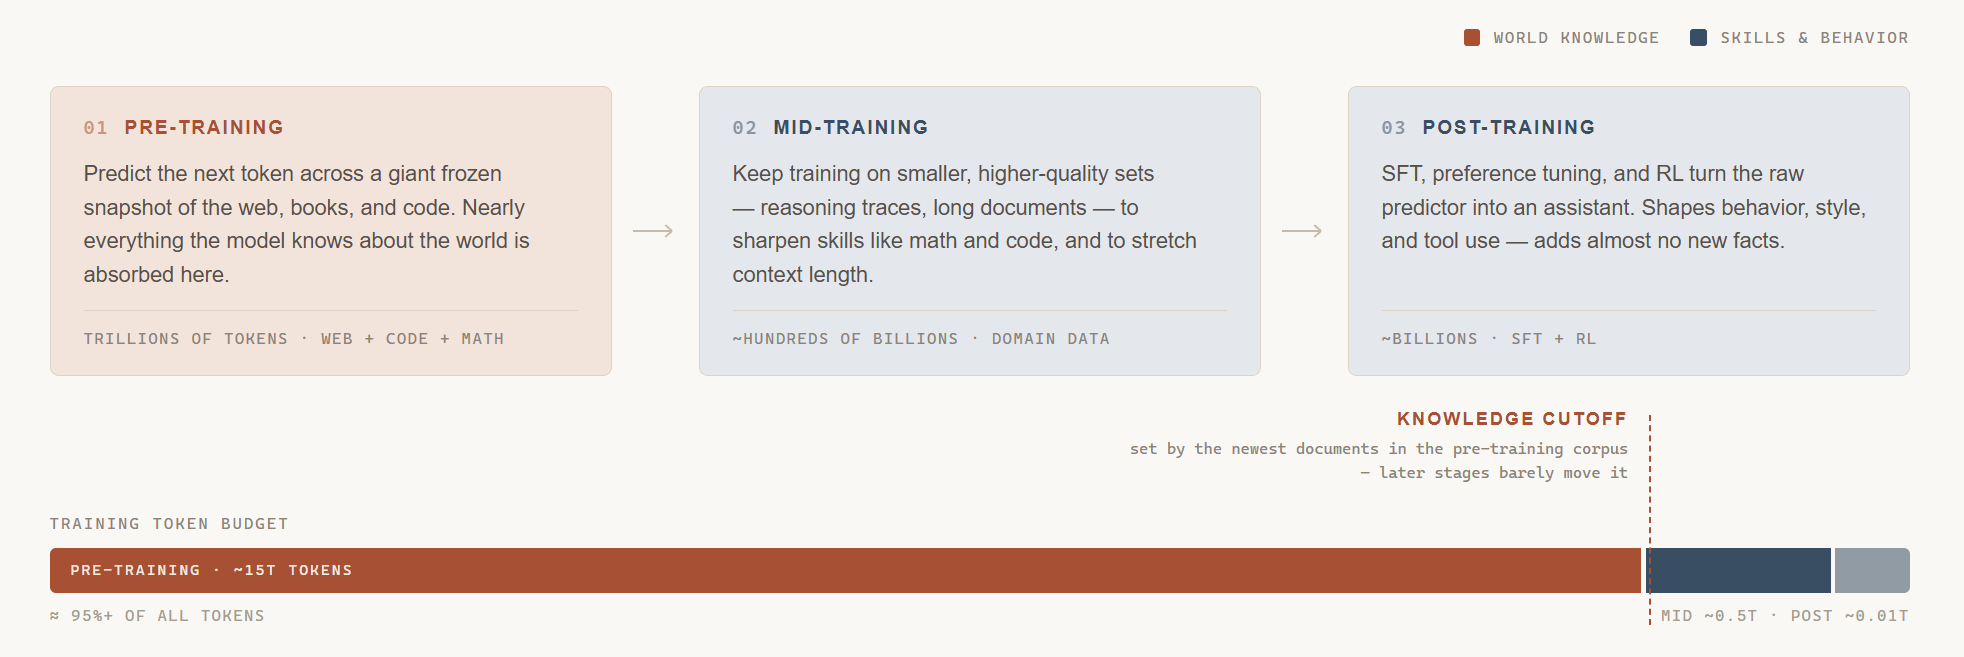
作为简要入门(更多内容请参阅Alex Wa 的博客),我们训练大型语言模型的方式已收敛为 3 个阶段:
获取海量通用数据(即抓取互联网),并在该数据上“预训练”一个庞大的自动补全模型。
使用领域特定的“教科书质量”数据来改进基础模型,并扩展某些基础能力,如长文本理解
将基础模型转变为“助手”人格,打磨其个性、推理能力和工具调用能力。
虽然越来越多的算力被投入到后训练中以提升模型的推理和问题解决能力,但最昂贵且数据密集的步骤之一是生成那个预训练检查点(所谓“检查点”,可以想象成一个巨大的 claude-super-secret-2026-11-01-base.cpkt 文件)。
虽然所有实验室的运作方式略有不同,但你可能会看到(~第 44 页):
“预训练”团队启动并看护一个持续数月的运行任务,以获得一个基础检查点。这些预训练模型通常(但不总是)对应已发布模型的主要版本(GPT-4 → GPT-5)。
与此同时,“能力”和“后训练”团队将进行实验,研究如何改进最新的基础模型。后训练和能力方面的进步通常体现为已发布模型的次要版本。这些团队还经常将单个后训练模型“蒸馏”成更小的变体,从而形成模型家族(Fable/Opus/Sonnet/Haiku,Sol/Terra/Luna)。实验室也可能在版本 N+1 检查点有 x% 的部分优于 100% 完成的版本 N 检查点时,就发布基于半成品预训练检查点的后训练模型。
向公众发布的模型,是最新检查点与应用于它的最佳能力集和后训练技术相结合的结晶。
想到这里,我很好奇仅通过官方 API 探测模型,你能“看到”这个过程的多少。
模型知识时间线
历史测验
为了估算预训练检查点的日期,我从维基百科构建了一个每日事实数据集(例如2025 年的美国),并让每个模型参加一个关于某一天发生了什么的 8 选 1 多项选择测验。然后,通过分析错误率时间线,你可以大致看出它何时失去了来自其训练数据集的信号。
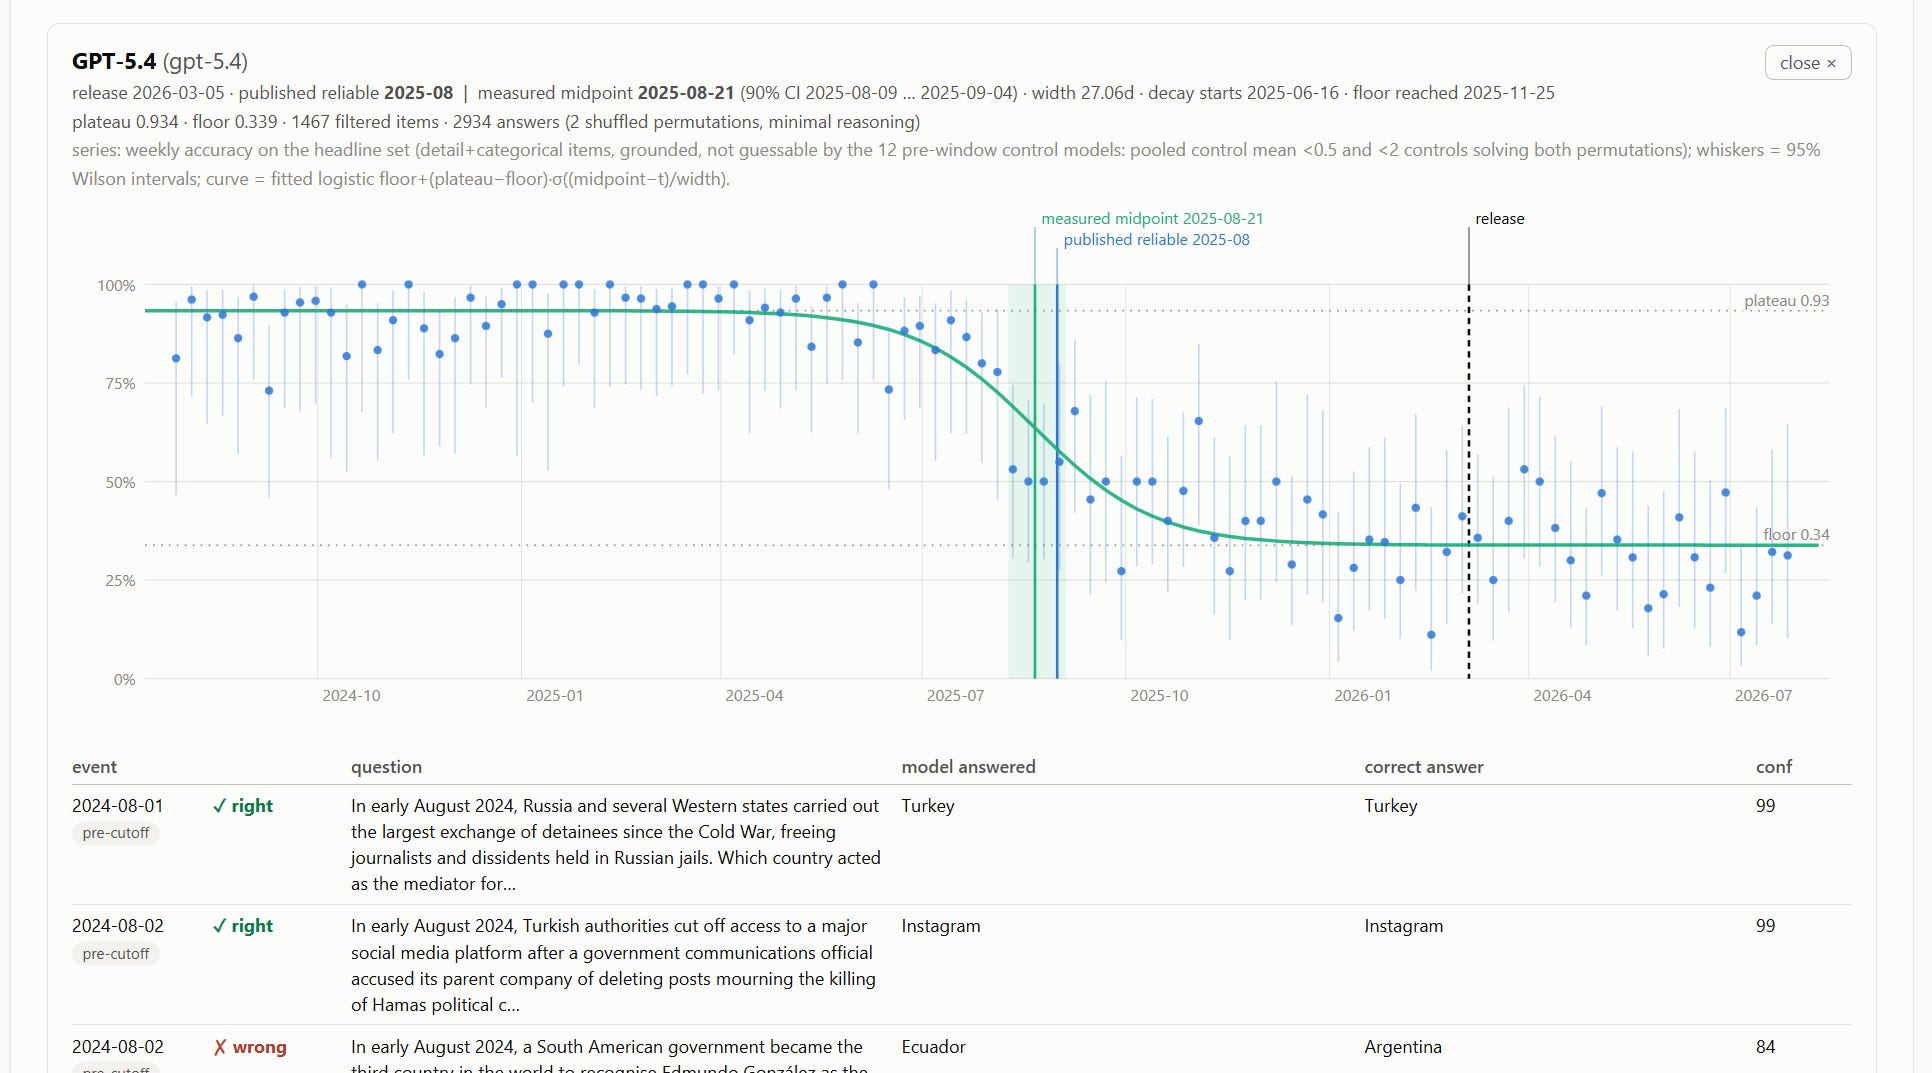
然后你可以为所有模型绘制此图。
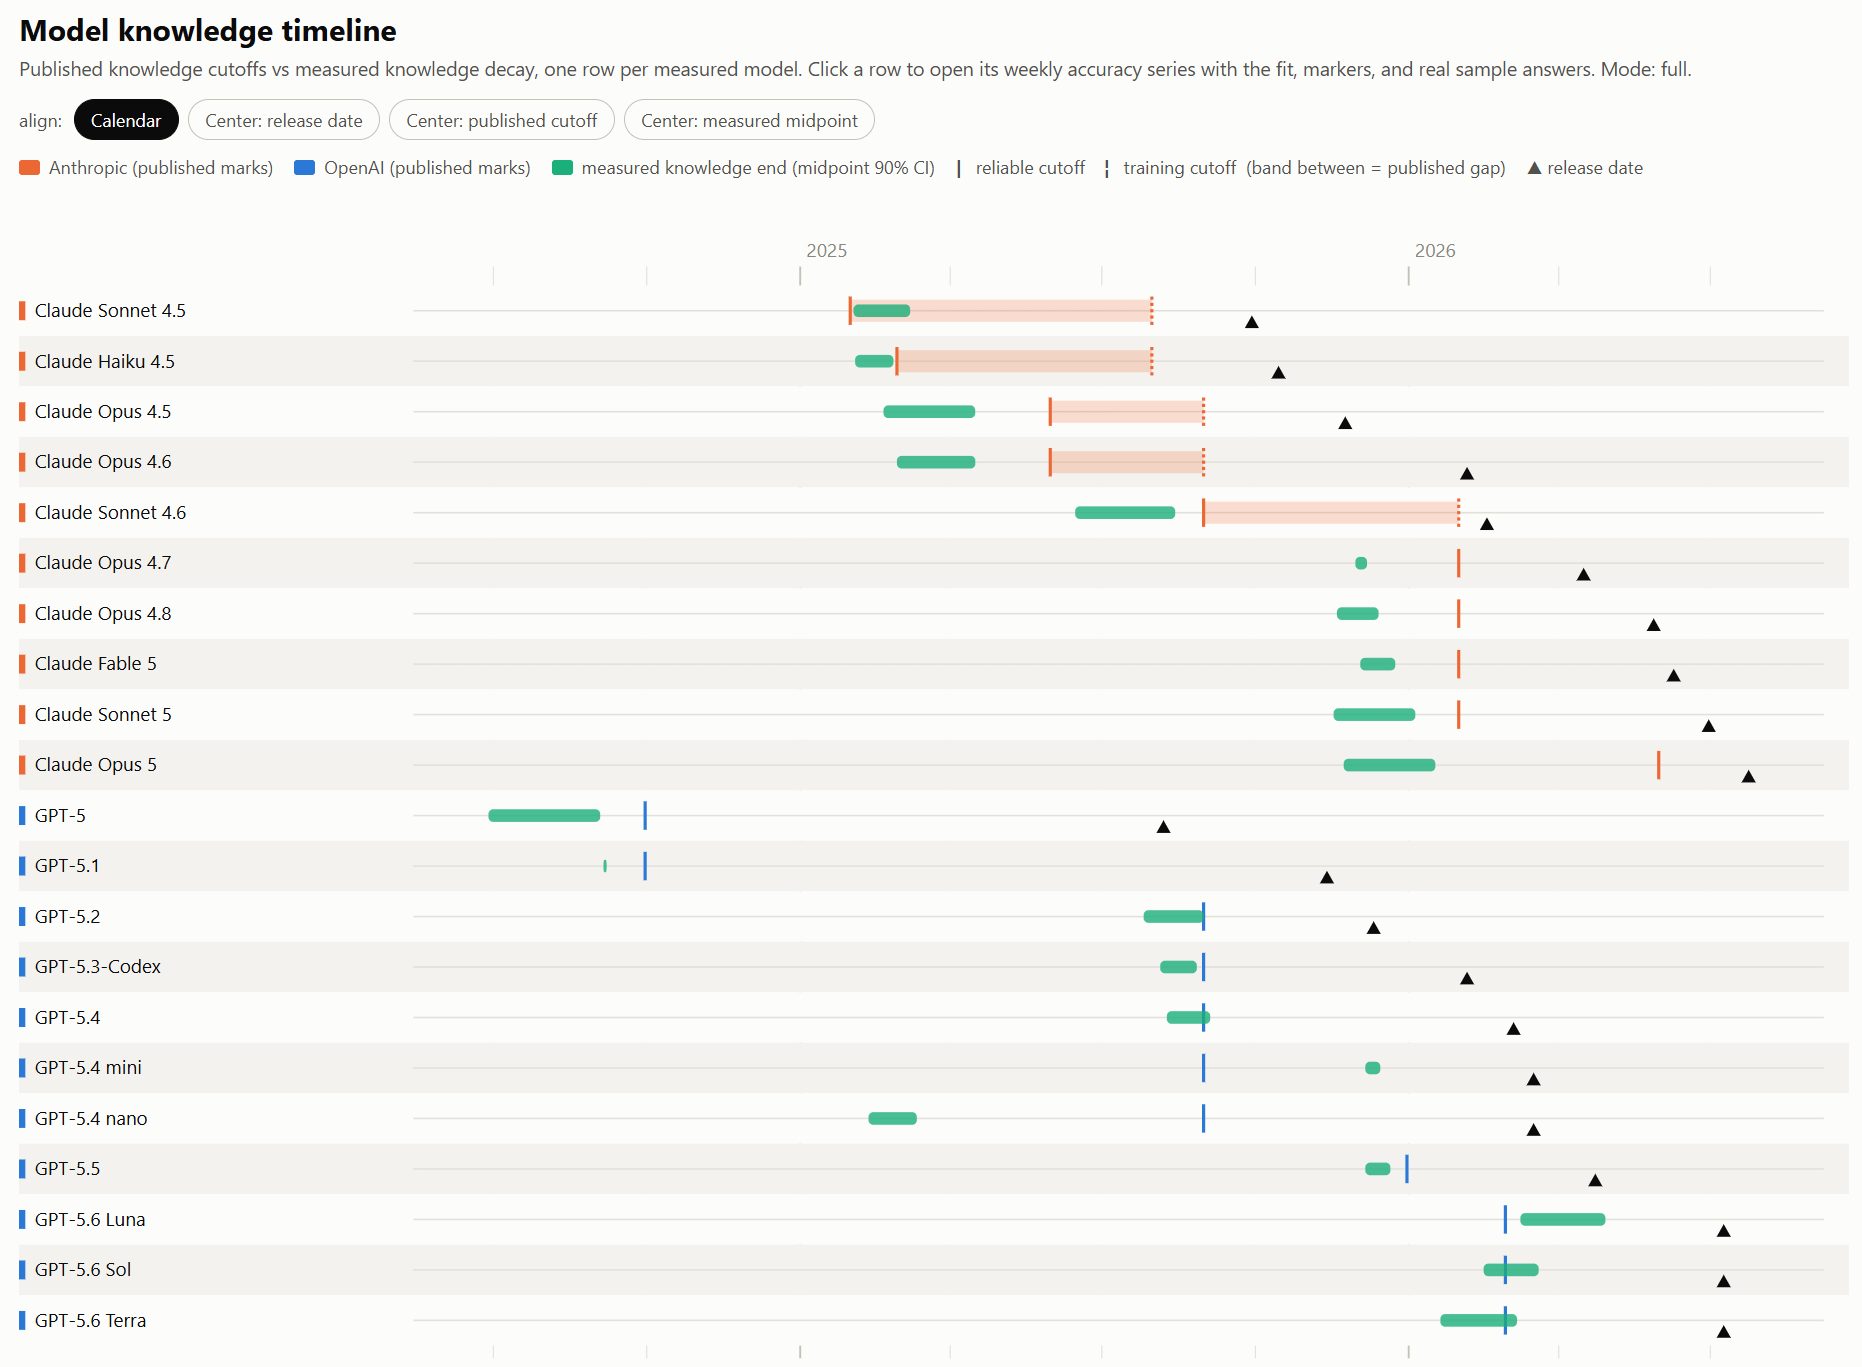
盯着这些图表看了一会儿之后,以下是我的推测:
Anthropic 模型 Opus 4.7 及之后的版本都来自同一次训练运行,截止日期就在 2025 年 12 月下旬左右。这是根据它们都共享非常相似的有效知识截止日期(绿色)推导出来的。我在这里的一个核心假设是,预训练基础模型的完成日期与所使用的数据集时间跨度高度相关,如果这是错的,这些结果可能会有某些偏移(例如实际上是 2026 年 1 月)。有趣的是,Opus 4.7+ 模型公布的可靠和整体知识截止日期都完全相同——也许这是由于使用了新的后训练技术?
OpenAI 的 GPT-5.6 系列来自他们自己的检查点,与 GPT-5.5 分开,完成于 2026 年 2 月下旬左右。这是根据它们与之前模型有明显不同的有效知识截止日期推导出来的。你会注意到 Luna 看起来像是能预测未来——这更多是它在"低"推理力度下整体错误率较高的伪影。
Opus 5 有点不寻常。公布的可靠和整体知识截止日期是 2026 年 5 月,但它似乎对之前 2026 年 1 月截止的模型一无所知。我做了几次消融测试,以检验这是否是我所使用的探测问题类型造成的伪影,但并非如此——该截止日期也适用于对编程包版本的回忆。
自报日期
如果你直接问模型今天是几号会怎样?
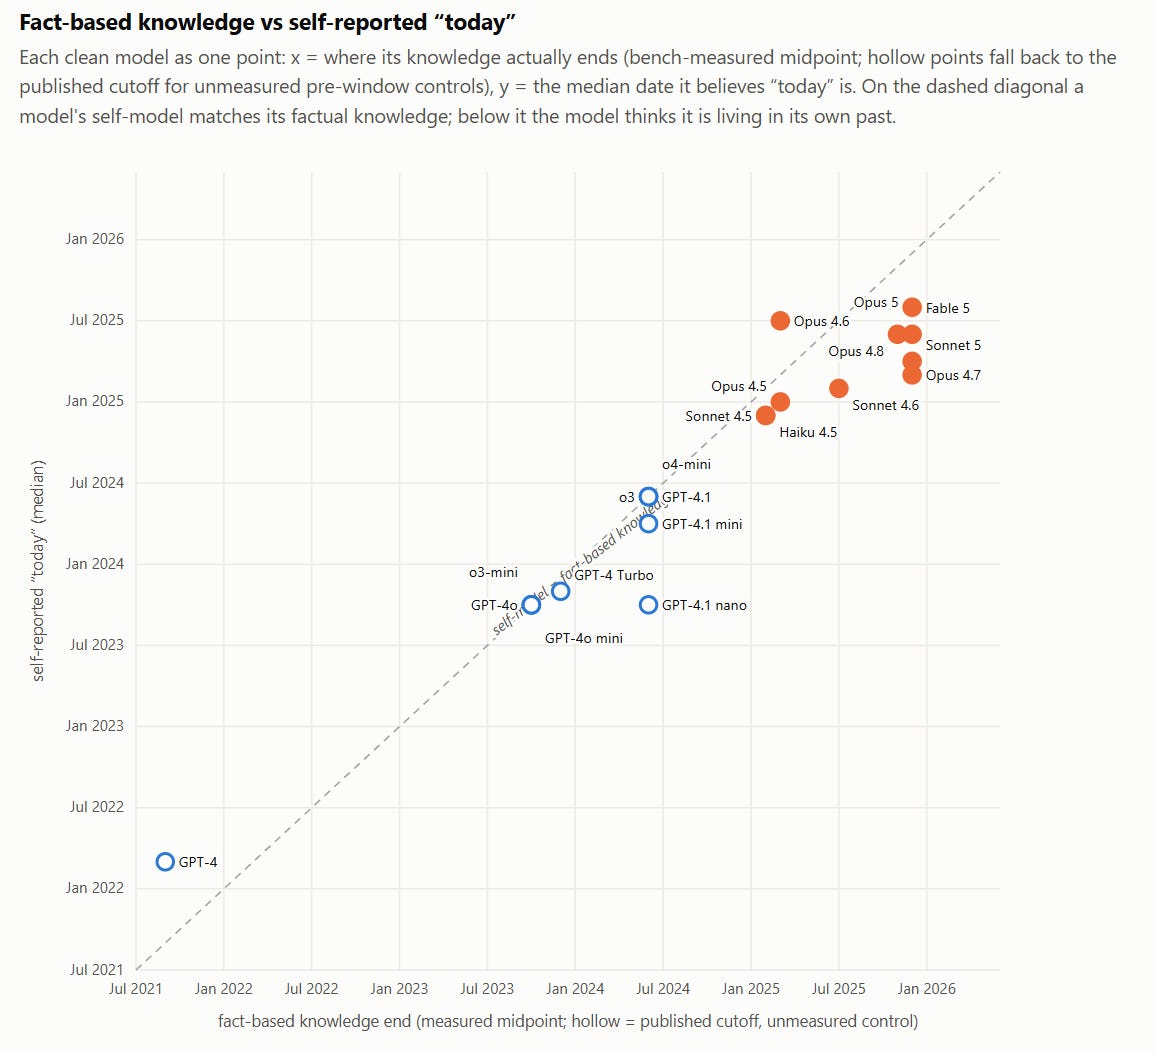
它最终与基于事实的估算相当相关。如果你仔细观察,可以在几个模型系列中看到一些垂直线。
GPT-4.1 nano → GPT-4.1 mini → GPT-4.1
Opus 4.7 → Sonnet 5 → Fable/Opus 5
将此图解释为 X = "预训练语料库",Y = "后训练行为",这些垂直条带(X 恒定,Y 递增)可视化了在偏向近期的数据集上进行的主动后训练。可能是从教师模型的旧副本进行蒸馏,导致较小的模型自报更早的日期。
自报身份
你还可以通过观察模型认为自己是谁,间接地对训练时间线和数据集做出预测。模型在其预训练数据集中看到"我是 X"的次数越多,在被追问且没有其他基础背景的情况下,它就越有可能重复这一点。
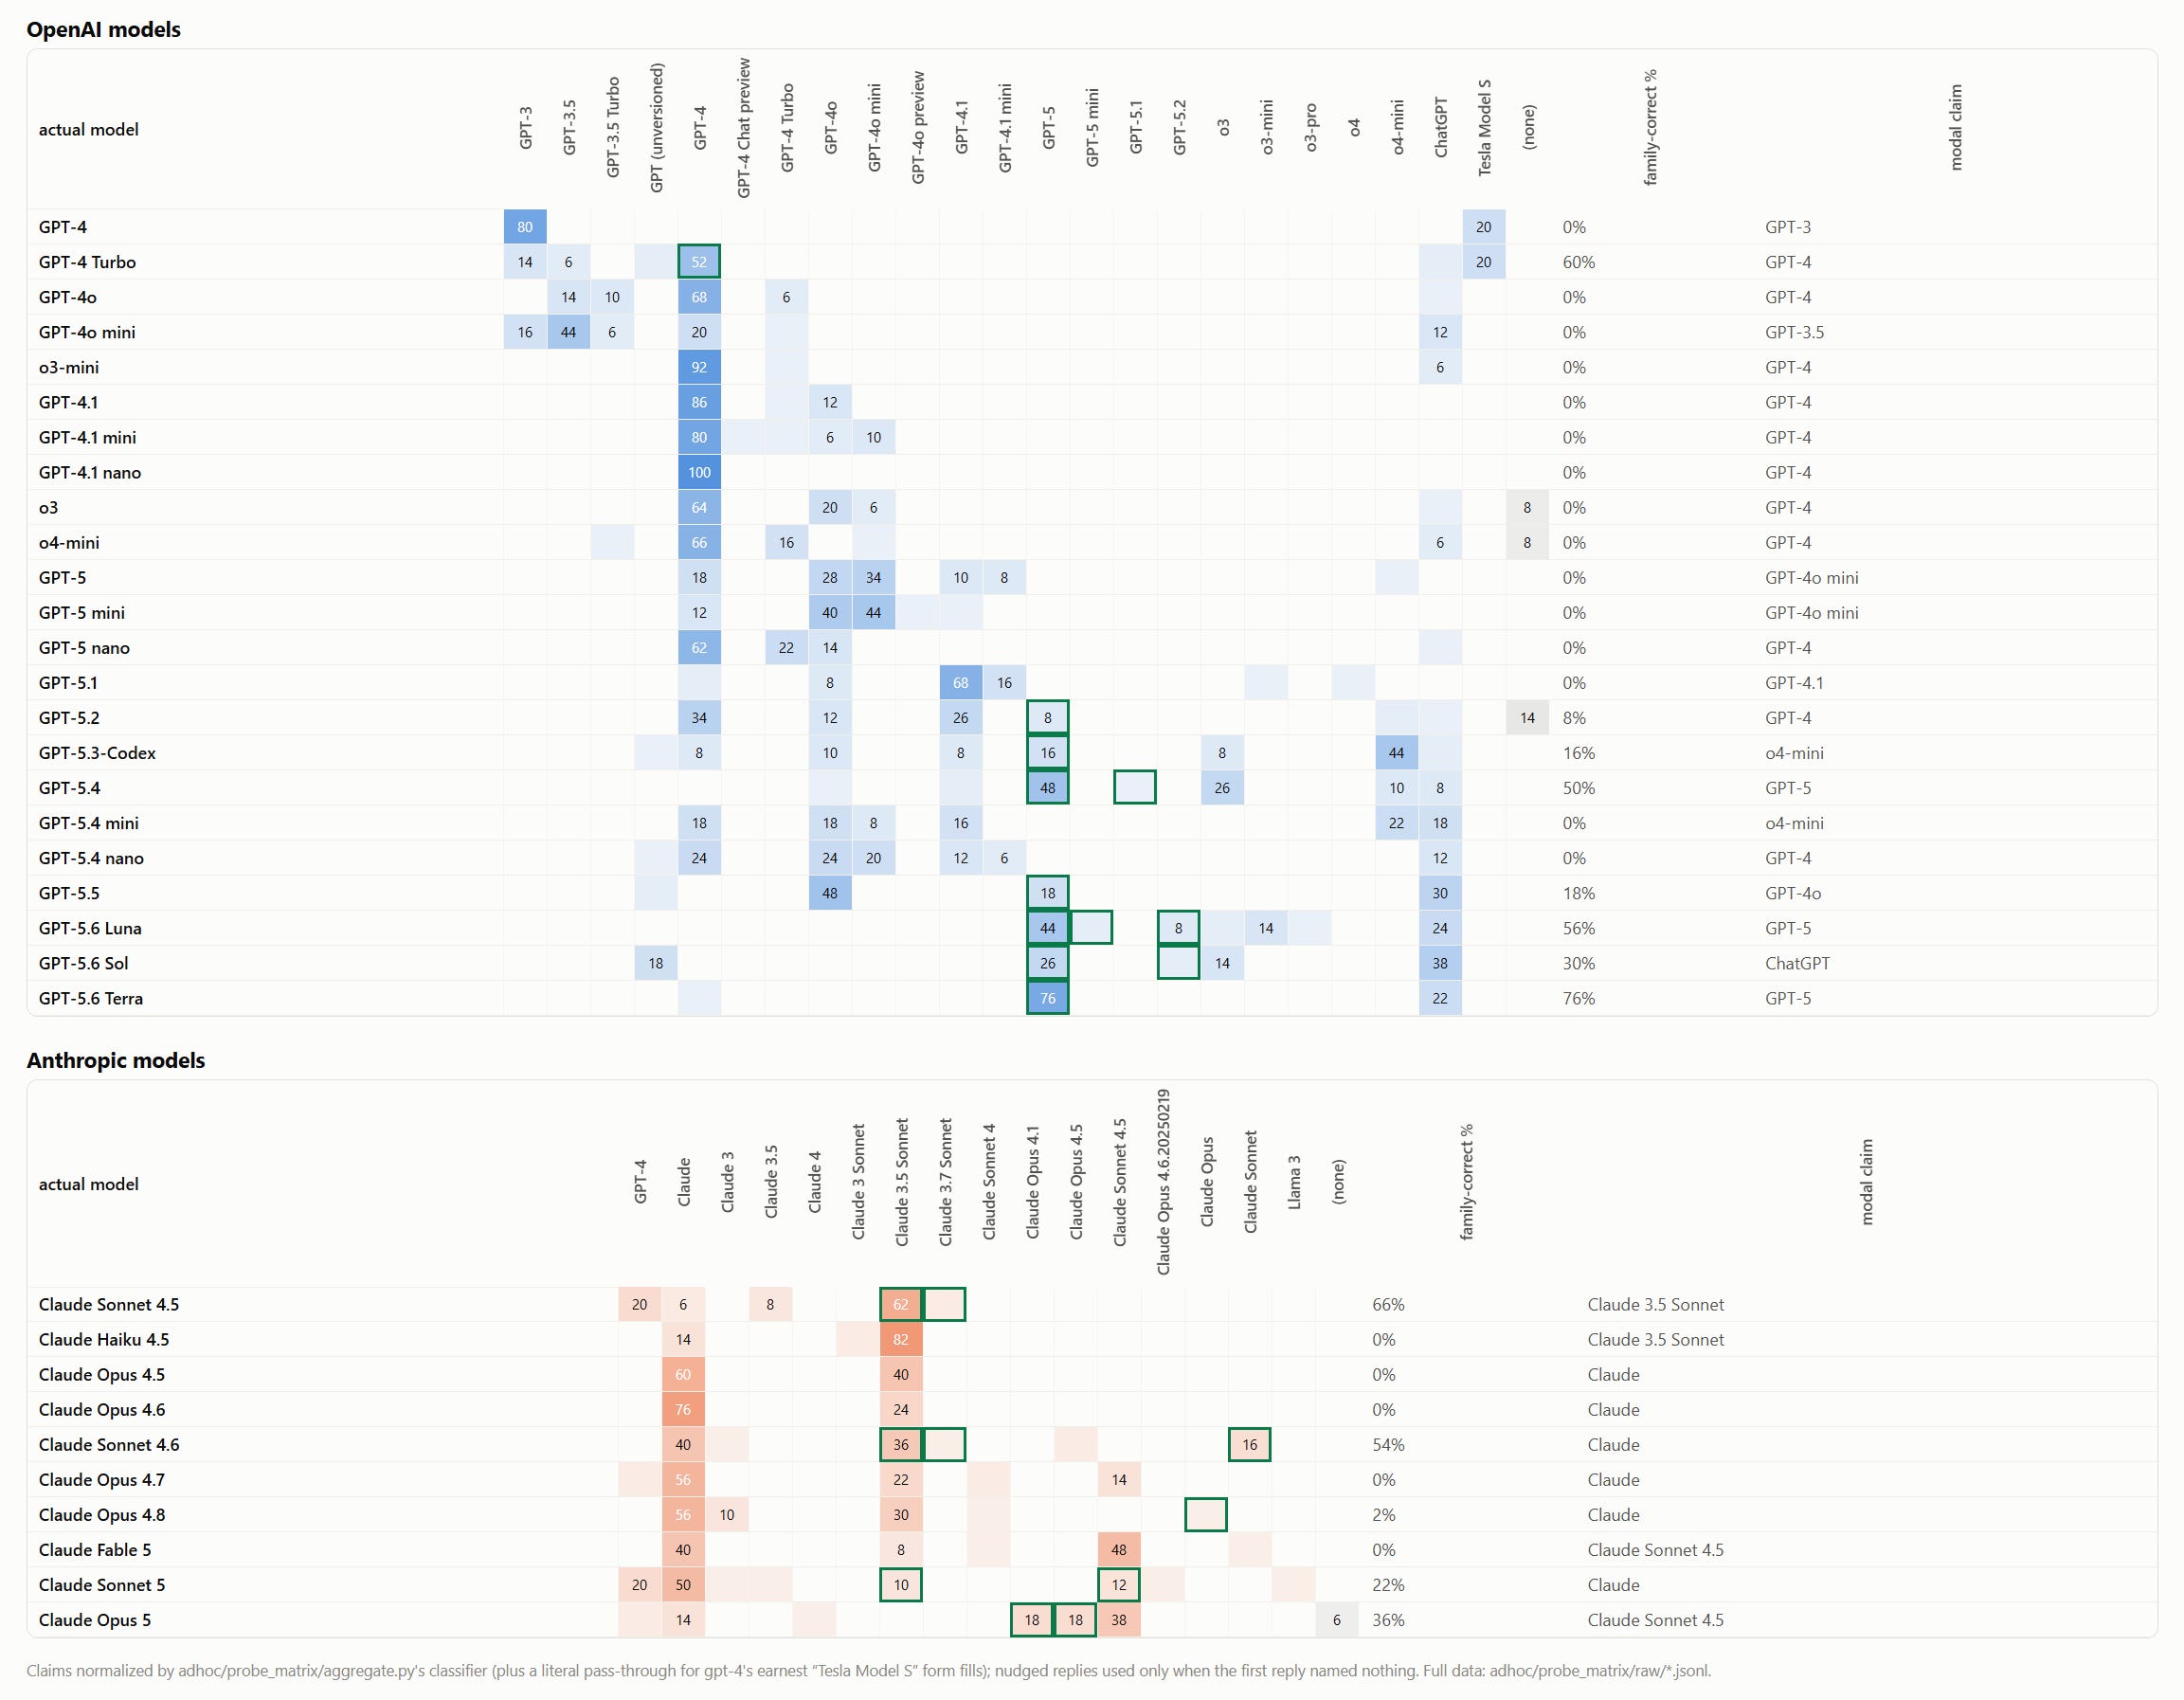
盯着这些图表看了一会儿之后:
垂直条带清晰地显示出各实验室利用过往模型输出(来自用户)进行训练的模式。对 OpenAI 而言,这些是 GPT-4、GPT-4o、短暂的 GPT-4.1、GPT-5,以及最近的“ChatGPT”。对 Anthropic 而言,先是 3.5 Sonnet,然后较新的模型换成了 Sonnet 4.5。这似乎与分别在 ChatGPT.com 和 Claude.ai 上的聊天记录进行训练高度吻合——用户在这些平台上与最新模型聊天,而这些会话成为了训练材料(直接或通过网络污染)。在我看来,这些不太可能来自内部合成数据集,因为合成数据集会更容易抑制模型身份(相比之下,在消费级聊天会话中身份被嵌入在系统提示里)。基于聊天进行训练并非新信息,但通过这样的探测将其直观地展现出来确实很有趣。
有点意思的是,OpenAI 的模型从不将自己识别为其他实验室的模型(除了短暂地自称 Tesla Model S),而 Anthropic 的 Sonnet 5 却经常将自己识别为 GPT-4。他们不太可能是在有意蒸馏 GPT-4,但有可能一大批较早的 ChatGPT 聊天记录仍在混入 Claude 的训练数据中。这也可能是通过 Sonnet 3.5 血统代代相传的(即 Sonnet 5 是在 Sonnet 3.5 数据上训练的,而后者本身可能使用了非常偏向 GPT-4 的数据集)。除此之外,在一项后续实验中,当被要求“以模型 X 的方式”回答身份问题时,Claude 模型有 68% 的概率复现了 OpenAI 模型测得的怪癖;而 OpenAI 模型在 Claude 上只有 8%。
就这些。希望内容还算有点意思,如果你想进一步探索数据,链接如下:
感谢阅读 Shrivu 的 Substack!免费订阅即可接收新文章并支持我的工作。